GPUを支える技術を読んで学んだ内容をメモしてます。
www.amazon.co.jp/dp/4297119544
ディスプレイの違い
CRT(ブラウン管)
電子銃から照射された電子ビームがブラウン管の蛍光面に当たることで発光する。
プラズマ
電極から各セル内に封入したガスに電流を流して放電させるとプラズマが発生し、その紫外線がRGBの蛍光体にあたることで発光する。
液晶
液晶(RGBのサブピクセル)に電圧をかけて偏光方向を調整することで、バックライトを表示する。
主に3つの方式がある。
TN方式
- 応答が速い
- 視野角によって色が変化する、色再現性で劣る(白っぽい)
- 比較的安価
VA方式
- 高コントラストを表現できる (黒が深く表現される)
- 応答速度は遅い
- 残像(ゴースト)が起きやすい
IPS方式
- 色再現性が高い
- 視野角による色変化が少ない
- コントラストの表現がVAに劣る
有機EL (OLED)
LEDと同様の仕組みで、電流によって有機物質を発光させる。
膜の厚みが非常に薄いため、曲げたり極端に薄く出来たりする。
- バックライトが無いため、コントラストを完璧に表現できる
- 応答速度が液晶に比べて非常に速い
- 同じ画像を表示していると、その部分の素子が劣化して焼付きが起こる
CPUとGPUの違い
参照: https://zenn.dev/nakano_teppei51/articles/7ff39a9ff6c4b2
コア数の対応関係
CPUコア ↔ GPUの SM(Streaming Multiprocessor) + CUDAコア
- CPU: 分岐予測・投機実行・アウトオブオーダーで1処理を最速で実行することを目指す
- GPU: SMが ワープ(32スレッド単位) で命令発行 → 32個のCUDAコアが同一命令を異なるデータに一斉実行
DDR vs GDDR
| DDR(CPU用) | GDDR(GPU用) | |
|---|---|---|
| 接続 | CPUメモリコントローラ↔DIMM↔メモリ | GPUに直付け |
| 強み | レイテンシ・容量・拡張性 | 帯域 |
| バス幅 | 64bit/ch(DDR5は32bit×2) | 32bit/チップ |
| 総バス幅 | デスクトップ2ch構成で128bit | 128〜512bit(コンシューマGPU) |
| 転送レート | DDR5: 5600〜6400 MT/s | GDDR6: 16〜20Gbps/GDDR7: 28〜32Gbps |
| 帯域 | 〜100GB/s前後 | 数百GB/s〜1TB/s超 |
| 容量 | 16〜64GB | 8〜32GB |
GDDRは物理的にGPU直付けで近いのにも関わらず、実レイテンシはDDRより長い。 帯域優先で深いプリフェッチ+多値信号のエンコード/デコードを挟むため、初速が遅くなる(=距離で稼いだ分をここで失う)。
CPU ↔ GPU間の接続
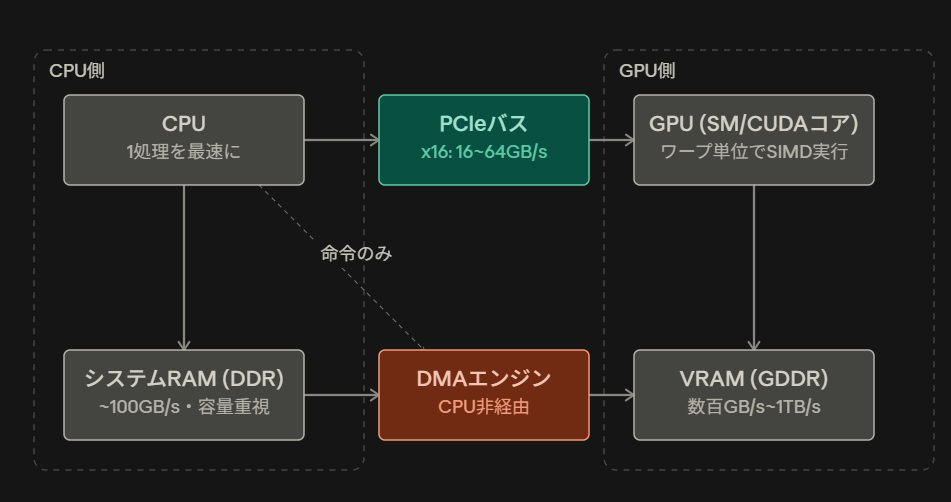
GPUはマザーボードのPCIeスロットに刺さり、CPUと繋がっている。
DMA(Direct Memory Access)エンジンは、CPUを介さずにメモリ間のコピーを行う専用ハードウェア。
GPUには通常、演算とは別に1〜複数のコピーエンジン(DMAエンジン)が載っている。
CPUは「このアドレスからこのアドレスへN バイトコピーして」と命令を出すだけで、あとはDMAエンジンが裏で転送を進める。CPU/GPUの演算コアは他の仕事を並行して続けられる。
これによって、「計算」と「転送」を同時に行うことができる。
例えば今フレームの描画をGPUが計算している間に、次フレームで使うテクスチャをDMAで非同期アップロードする、というダブルバッファ的なテクニックが可能になる。
基本的には、CPU側が「このアドレスからこのアドレスへ、このサイズだけコピーして」とDMAエンジンにまとめて指示を出し、DMAエンジンが裏で一括転送する。
SIMD方式とSIMT方式
3Dグラフィックスでは、X、Y、Zの3つの座標に加え、表示を行う2次元平面への投影などを行うためのWの4要素で各頂点を表す。従って、4つの要素に対して一括で同じ演算を行うことが出来れば、演算効率を向上させることができる。
SIMD (Single Instruction, Multiple Data)
複数の値を1本のレジスタにまとめて詰め込み、1回の命令で処理する方法。
CPUには、SSE/SSE2 (128bit), AVX/AVX2 (256bit)等のSIMDレジスタが搭載されていて、最低でも32bit × 4 = 128bitのSIMD演算を行うことができる。
SIMT (Single Instruction, Multiple Threads)
スレッドごとにレジスタを分けて割り当て、同じ命令を全スレッドに配って処理する方法。
| ベンダー | 呼び方 | まとめる単位のサイズ | 備考 |
|---|---|---|---|
| NVIDIA | ワープ(warp) | 32スレッド固定 | 「SIMT」はNVIDIAが作った用語 |
| AMD | ウェーブフロント(wavefront) | GCN世代: 64固定/RDNA世代: 32 or 64 | AMD自身は「SIMD実行」と呼ぶことが多い |
| Intel(Arc) | サブグループ(subgroup) | 実装依存(8/16/32) | XeアーキテクチャのEU単位 |
※PS5/Xbox SeriesはAMDのRDNA2
ここでまとめるとキリがないので、別ページでまとめたい。